gRPC とは
はじめに
前回は Protocol Buffers の基礎をまとめました。今回は gRPC の基礎。
gRPC とは
gRPC は、Google によって 2015 年にオープンソース化された RPC(Remote Procedure Call)のためのプロトコル。
RPC(Remote Procedure Call)とは
- Remote = 遠隔地(リモート)サーバーの
- Procedure = 手続き(メソッド)を
- Call = 呼び出す(実行する)
ネットワーク上の別のサーバーにあるメソッドを、まるでローカルの関数を呼び出すように実行できる仕組み。 REST API のようにパスやメソッド(GET/POST など)を指定する必要はなく、メソッド名と引数を指定するだけで通信可能。
gRPC の特徴
- データフォーマットに Protocol Buffers を使用
- バイナリにシリアライズすることで送信データ量が減り、高速な通信を実現
- 型付けされたデータ転送が可能
- IDL(Protocol Buffers)からコードを自動生成
- サーバー側・クライアント側に必要なソースコードを生成
- 通信に HTTP/2 を使用:多重化・ストリーミングなどの恩恵を受けられる
- 特定の言語やプラットフォームに依存しない
gRPC が適したケース
- Microservice 間の通信
- 複数の言語やプラットフォームで構成される可能性がある
- モバイルユーザーが利用するサービス
- 通信量が削減できるため、通信容量制限にかかりにくい
- 速度が求められる場合
gRPC の開発の流れ
.protoファイルの作成.protoファイルをコンパイルしてサーバー・クライアントの雛形コードを作成- 雛形コードを使用してサーバー・クライアントを実装
前回学んだ Protocol Buffers の知識がそのまま第一歩になっている。
Service とは
Service は RPC(メソッド)の実装単位。
- サービス内に定義するメソッドがエンドポイントになる
- 1 サービス内に複数のメソッドを定義できる
- サービス名・メソッド名・引数・戻り値を定義する必要がある
- コンパイルして Go ファイルに変換するとインターフェイスとなり、アプリケーション側でそのインターフェイスを実装する
.proto ファイルでは service ブロックの中に rpc でメソッドを定義。
message SayHelloRequest {}
message SayHelloResponse {}

service Greeter {
  rpc SayHello (SayHelloRequest) returns (SayHelloResponse);
}
rpc メソッド名 (引数の型) returns (戻り値の型) という構文で、「どんなデータを受け取って、どんなデータを返すか」を定義。
gRPC の 4 種類の通信方式
Unary RPC
1 リクエスト・1 レスポンス の方式。
通常の関数コールのように扱うことができる。用途は API など。
service Greeter {
  rpc SayHello (SayHelloRequest) returns (SayHelloResponse);
}
Server Streaming RPC
1 リクエスト・複数レスポンス の方式。
クライアントはサーバーから送信完了の信号が送信されるまでストリームのメッセージを読み続ける。用途はサーバーからのプッシュ通知など。
service Greeter {
  rpc SayHello (SayHelloRequest) returns (stream SayHelloResponse);
}
returns の後の型に stream を付ける。
Client Streaming RPC
複数リクエスト・1 レスポンスの方式。サーバーはクライアントからリクエスト完了の信号が送信されるまでストリームからメッセージを読み続け、レスポンスを返しません。用途は大きなファイルのアップロードなど。
service Greeter {
  rpc SayHello (stream SayHelloRequest) returns (SayHelloResponse);
}
引数側の型に stream を付ける(Server Streaming は戻り値側)。
Bidirectional Streaming RPC
複数リクエスト・複数レスポンス の方式。
クライアントとサーバーのストリームが独立しており、リクエストとレスポンスはどのような順序でもい。用途はチャットやオンライン対戦ゲームなど。
service Greeter {
  rpc SayHello (stream SayHelloRequest) returns (stream SayHelloResponse);
}
引数・戻り値の両方に stream を付ける。
stream の位置まとめ
stream をどちら側に付けるかで、誰が複数のメッセージを送るかが決まる。
| 通信方式 | Service 定義 |
|---|---|
| Unary RPC | rpc Method (Request) returns (Response) |
| Server Streaming RPC | rpc Method (Request) returns (stream Response) |
| Client Streaming RPC | rpc Method (stream Request) returns (Response) |
| Bidirectional Streaming RPC | rpc Method (stream Request) returns (stream Response) |
Unary RPC を実装する
まとめ
- gRPC は Google 製の RPC プロトコルで、メソッド名と引数で通信する
- Protocol Buffers をデータフォーマットとして使用し、HTTP/2 で通信する
.protoファイルにserviceを定義し、コンパイルして生成されたインターフェイスを実装する--go_outで message の struct、--go-grpc_outで service のインターフェイスを生成する- 通信方式は 4 種類あり、
streamキーワードの位置で使い分ける
Protocol Buffers とは
はじめに
Go を使って gRPC を学んでいく過程をまとめます。
現職では Java を使っていますが、Go のほうが気軽に動かせそうだったので。
Protocol Buffers とは
Protocol Buffers(protobuf)は、Google が 2008 年にオープンソース化したスキーマ言語。
特徴
- gRPC のデータフォーマットとして標準採用
- 言語非依存(Java・Go・など多数に対応)
- バイナリ形式にシリアライズするため、軽量・高速
- 型安全にデータのやり取りができる
- 必要に応じて JSON への変換も可能
JSON との比較
| 項目 | JSON | Protocol Buffers |
|---|---|---|
| 可読性 | ヒューマンリーダブル | バイナリは人間が読めない |
| 型安全 | スキーマを強制できない | 型が保証される |
| データサイズ | 大きくなりがち | 小さい |
| 言語対応 | あらゆる言語で読める | 一部未対応あり |
.proto ファイルの書き方
message
各言語のデータ構造に変換(Go では struct、Java ではクラス)。
message Person {
  string name  = 1;
  int32  id    = 2;
  string email = 3;
}
= 1 などの数字はタグ番号で、値の代入ではなくフィールドの識別。
フィールド名を変更してもデータの互換性が維持される。
逆に、タグ番号を変えると既存のバイナリデータが読めなくなるため変更厳禁。
タグ番号のルール
- 一意(重複不可)、最小値 1
- 19000〜19999 は予約済みで使用不可
- 1〜15 は 1 byte で表現できるため、頻出フィールドに割り当てると効率的
enum
enum Occupation {
  OCCUPATION_UNSPECIFIED = 0;  // 必ず0から始める
  OCCUPATION_ENGINEER    = 1;
  OCCUPATION_DESIGNER    = 2;
}
message のタグ番号は 1 始まり、enum は 0 始まり。
先頭に UNSPECIFIED = 0 を置くのが一般的なパターン。
repeated
同じ型の値を複数持ちたい場合に使用。Go ではスライス([]string など)として生成。
1 人のユーザーが複数の電話番号やメールアドレスを持つ場合など、「1 対 多」の関係。
message Employee {
  repeated string phone_number = 5;  // Go: []string
}
map
キーと値のペアを持ちたい場合に使用。Go の map に相当。
「プロジェクト名をキーにプロジェクト情報を引きたい」「設定値をキーバリューで持ちたい」など、名前で値を引けるようにしたい場面で使用。
message Employee {
  map<string, Company.Project> project = 6;  // Go: map[string]*Company_Project
}
oneof
複数のフィールドのうち、最大 1 つだけ値を持てることを表す。どれか 1 つがセットされると、他はクリアされる。
「テキストか動画か、どちらか一方だけプロフィールに設定できる」など、排他的な選択肢を表したい場面で使用。oneof を使わずに複数のフィールドを並べた場合、複数が同時にセットされてしまう可能性があるが、oneof を使えばそれを防げる。
message Employee {
  oneof profile {                // どれか1つだけ値を持つ
    string text  = 7;
    Video  video = 8;
  }
}
デフォルト値
| 型 | デフォルト値 |
|---|---|
string |
空文字 |
bool |
false |
| 整数・浮動小数点 | 0 |
enum |
タグ番号 0 の値 |
repeated |
空リスト |
Go のコードを生成する
.proto ファイルに go_package オプションが必要。Go のモジュールパスと protoc の出力先を紐づける役割を持つ。
protoc -I./proto --go_out=paths=source_relative:gen proto/employee/v1/*.proto
-I(--proto_path): import のパス解決に使うルートディレクトリを指定paths=source_relative:-Iで指定したパスからの相対パスを基準に.pb.goを出力- 省略すると
option go_packageの値が付加されたパスに出力される
実行後、gen/ ディレクトリ以下に .pb.go が生成されます(.pb. は protoc 自動生成ファイルを示す命名規則)。
Go で Protocol Buffers を操作した GitHub
次回、gRPC の予定
fluentd の CPU 増加をきっかけに、Kubernetes のネットワーク経路を追跡
はじめに
(1年以上前の話・・・)
proxy namespace の app pod で動いている fluentd コンテナの CPU 使用率の増加原因について、調査しました。
その際、そもそものネットワーク経路について疑問を持ち、外側のネットワークから Kubernetes(OpenStack)の内側までを追跡したのでその記録です。
構成の全体像
最終的に判明したトラフィックの流れは以下の通りです。
external client
    ↓
app.example.com(ドメイン)
    ↓
203.0.113.10(Floating IP)
    ↓
10.200.x.x(OpenStack Load Balancer / Octavia amphora)
    ↓
10.200.x.x:30052(Kubernetes Ingress Node / NodePort)
    ↓
ingress-nginx-controller Service
    ↓
ingress-nginx Pod
    ↓
各アプリケーション Pod(fluentd)
Step 1: ドメイン
まずはドメインの名前解決
% dig +short app.example.com
203.0.113.10
203.0.113.10 というIPアドレスが返ってきました。このIPが何に紐づいているかを調べます。
注: 本記事のIPアドレスは RFC 5737 で定義されたドキュメント用予約アドレス(
203.0.113.0/24など)に置き換えています。実際のルーティングには使われないため、サンプルIPとして安全に使用できます。
Step 2: Floating IP
OpenStack の CLI で Floating IP の一覧を引きます。
% openstack floating ip list | grep 203.0.113.10
| xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx | 203.0.113.10 | 10.200.5.92 | ... |
Floating IP が 10.200.5.92 というプライベートIP に関連付けられていることがわかりました。
次にこの IP が VM に紐づいているか確認します。
% ssh 10.200.5.92
(ssh 出きない)

% openstack server list | grep 10.200.5.92
(何も出ない)
SSH できないし、server list にも出てこないので VM ではなさそうです。
VM ではないなら、Load Balancer ..? という仮説を立てて調べます。
Step 3: Load Balancer
% openstack loadbalancer list | grep 10.200.5.92
| xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx | kube_service_production-cluster01-k8s_ingress-nginx_ingress-nginx-controller | ... | 10.200.5.92 | ACTIVE | DEGRADED | amphora |
ingress-nginx 関連の Load Balancer だとわかります。しかも DEGRADED 状態になっていました。
OpenStack Octavia は、OpenStack の Load Balancer as a Service(LBaaS)コンポーネントです。 Kubernetes の cloud-controller-manager と連携し、
Serviceリソースのtype: LoadBalancerに応じて自動的に Octavia LB を作成・管理します。 参照: OpenStack Octavia ドキュメント
Step 4: Load Balancer のバックエンド
Load Balancer にぶら下がっているメンバー(バックエンドノード)を確認します。
% openstack loadbalancer show kube_service_production-cluster01-k8s_ingress-nginx_ingress-nginx-controller -c pools
+-------+--------------------------------------+
| Field | Value                                |
+-------+--------------------------------------+
| pools | xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx |
|       | yyyyyyyy-yyyy-yyyy-yyyy-yyyyyyyyyyyy |
+-------+--------------------------------------+

% openstack loadbalancer member list xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx
+----...----+----------------------------------------+...+--------------+---------------+------------------+--------+
| id        | name                                   |...| address      | protocol_port | operating_status | weight |
+----...----+----------------------------------------+...+--------------+---------------+------------------+--------+
| ...       | production-cluster01-k8s-ingress-aaa01 |...| 10.200.4.101 |         30052 | ERROR            |      1 |
| ...       | production-cluster01-k8s-ingress-aaa02 |...| 10.200.4.102 |         30052 | ERROR            |      1 |
| ...       | production-cluster01-k8s-ingress-aaa03 |...| 10.200.4.103 |         30052 | ONLINE           |      1 |
| ...       | production-cluster01-k8s-ingress-aaa04 |...| 10.200.4.104 |         30052 | ONLINE           |      1 |
| ...       | production-cluster01-k8s-ingress-aaa05 |...| 10.200.4.105 |         30052 | ONLINE           |      1 |
+----...----+----------------------------------------+...+--------------+---------------+------------------+--------+
いくつかのメンバーが ERROR 状態になっています。これが DEGRADED の原因そうです。
production-cluster01-k8s-ingress-* になっていることから、Kubernetes の ingress ノードと予想が付きます。
Step 5: ingress ノードへ SSH
% ssh 10.200.4.101
harukin@production-cluster01-k8s-ingress-aaa01:~$
Kubernetes のノードでした。kubectl が使えます。
% kubectl get node | grep ingress
production-cluster01-k8s-ingress-aaa01   Ready    <none>   50d   v1.29.6
production-cluster01-k8s-ingress-aaa02   Ready    <none>   50d   v1.29.6
production-cluster01-k8s-ingress-aaa03   Ready    <none>   50d   v1.29.6
production-cluster01-k8s-ingress-aaa04   Ready    <none>   50d   v1.29.6
production-cluster01-k8s-ingress-aaa05   Ready    <none>   50d   v1.29.6
Step 6: port 30052
Kubernetes の世界から 30052 を検索します。
% kubectl get svc -A | grep LoadBalancer | grep 30052
ingress-nginx   ingress-nginx-controller   LoadBalancer   10.233.24.203   203.0.113.10.nip.io   80:30052/TCP,443:30356/TCP
30052 は ingress-nginx-controller Service の NodePort でした。
NodePort とは、KubernetesのServiceの公開方法のひとつです。クラスター内のすべてのノードの指定ポートを開け、そこへのアクセスをServiceにルーティングします。
30000〜32767の範囲が使われます。 参照: Kubernetes Service - NodePort
Step 7: Service
selector に一致するラベルを持つ Pod がトラフィックの最終的な受け口です。ingress-nginx-controller の Pod ということになります。
% kubectl -n ingress-nginx get service ingress-nginx-controller -o yaml
spec:
  allocateLoadBalancerNodePorts: true
  clusterIP: 10.233.24.203
  externalTrafficPolicy: Local
  healthCheckNodePort: 30228
  ports:
  - appProtocol: http
    name: http
    nodePort: 30052      # ← これがLBのバックエンドportと一致!
    port: 80
    protocol: TCP
    targetPort: http
  - appProtocol: https
    name: https
    nodePort: 30356
    port: 443
    protocol: TCP
    targetPort: https
  selector:
    app.kubernetes.io/component: controller
    app.kubernetes.io/instance: ingress-nginx
    app.kubernetes.io/name: ingress-nginx
    environment: production
  type: LoadBalancer
status:
  loadBalancer:
    ingress:
    - hostname: 203.0.113.10.nip.io
externalTrafficPolicy: Local は、NodePort経由のトラフィックをそのノード上にあるPodにのみルーティングします。 これにより送信元IPが保持されますが、対象Podがいないノードへのリクエストはドロップされます。これが一部のメンバーが
ERRORになっていた原因のひとつかもしれません。 参照: Kubernetes - Preserving the client source IP
まとめ
調査で判明したネットワークの経路を改めて整理します。
[外部クライアント]
    │
    ▼ DNS解決
app.example.com → 203.0.113.10 (Floating IP)
    │
    ▼ OpenStack Floating IP → Octavia Load Balancer
203.0.113.10 → 10.200.5.92 (Octavia amphora LB)
    │
    ▼ LB → NodePort (port 30052)
10.200.4.101〜105:30052 (ingress nodes)
    │
    ▼ NodePort → Service → Pod
ingress-nginx-controller Pod (ingress-nginx namespace)
    │
    ▼ Ingress ルーティング
各アプリケーション Pod(fluentd)
今回の構成では OpenStack Octavia (L4) が外部→ノードの転送を担い、ingress-nginx (L7) がHTTPレベルのルーティングを担っていました。
おわりに
fluentd の CPU 増加という小さな気づきから、OpenStack の Floating IP から Kubernetes の ingress まで、ネットワークを外から内へひとつひとつ追跡することができました。 また、この追跡では前職の尊敬するエンジニアに助言をいただきながら、理解を深めることができました。感謝。
参考リンク
47都道府県コンプリートの道のりは長い
ここまでの進捗
学生時代は部活ばっかりで、あんまり旅行に行けてなかった。
その反動なのか、働き始めてからは旅行に行く機会が増えた。増やした。
せっかくなら「47都道府県コンプリート」しようと思っている。
今年は有給消化があったこともあって、意外と進捗があった。
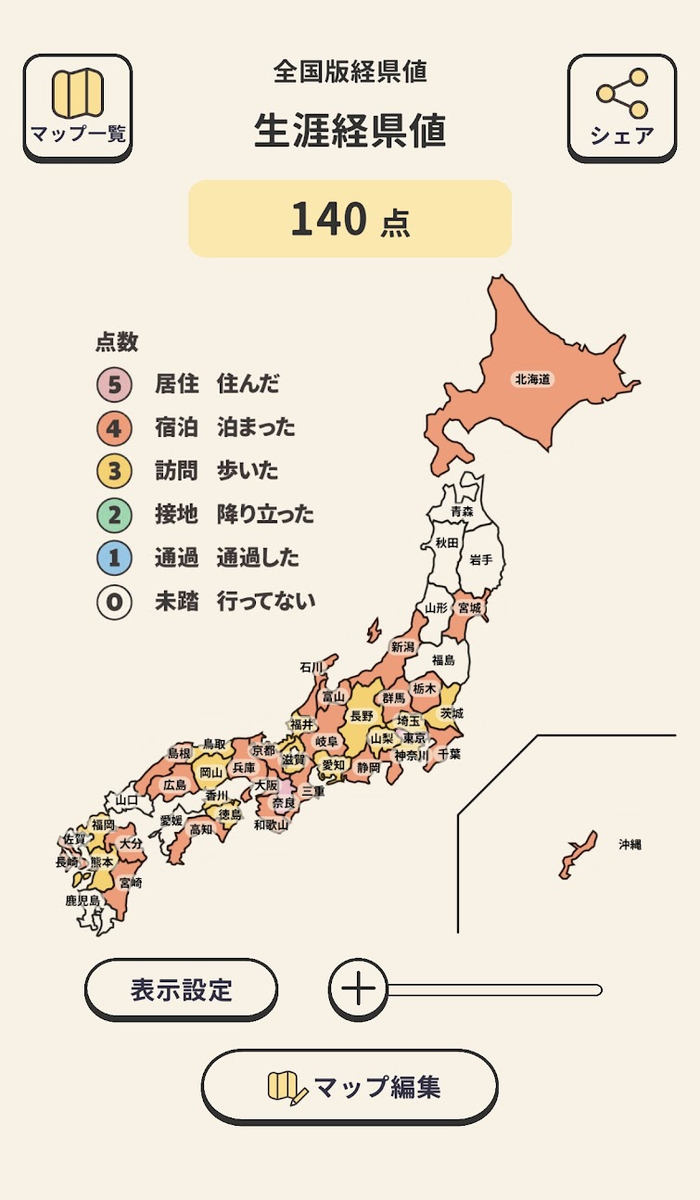
新しく行った
- 3月:新潟・熊本・大分
- 6月:岐阜
- 8月:富山・岡山
- 10月:島根・鳥取
- 11月:徳島
海無し県出身だからか、海を見て、毎回「おおー」ってなる。
残り
あと10ぐらい。
東北は、なんとなく後回しになっている(遠い)。
おわり
目標は、2026年、遅くとも 2027年4月(20代のうちに)には。 来年のこの時期ぐらいに達成しているのが理想。
Datadog カスタムメトリクスと複合条件モニターを活用した Progressive Delivery 基盤
はじめに
この記事は Datadog Advent Calendar 2025 の24日目の記事です。
こんにちは。アソビューで SRE をしている上島です。
これまでのキャリアでは Mackerel を使うことが多かったです。 今年 4 月に入社した現職では、可観測性まわりの基盤が Datadog を中心に構成されており、Datadog に向き合う時間が自然と増えました。
最近では、Datadog Bits AI SRE に関心を持っていて、 単にアラートを検知するだけでなく、運用そのものを効率化していくために、Datadog をより活用していけたらなと思っています。
先日、以下の記事で Argo Rollouts と Datadog を組み合わせた Progressive Delivery 基盤についてご紹介しました。
本記事ではその続編として、Canary(新バージョン)に特化した Datadog カスタムメトリクスと Monitor についてご紹介できればと思います。
課題:Canary の状態を正確に観測できない
Progressive Delivery を実現するためには、新バージョンの状態を正確に把握・分析できていることが重要です。
しかし Datadog の標準メトリクスでは、Stable(現行バージョン)と Canary(新バージョン)のリクエストやエラーが合算されてしまいます。 そのため、Canary のみで発生している異常が全体の数値に埋もれてしまい、問題に気づくのが遅れるという課題が見えてきました。
解決方針:Canary 専用メトリクスを発行する
この課題に対し、以下のアプローチを取りました。
Argo Rollouts が付与する Revision 情報を Pod Label(argo_rollouts_revision: stable / canary)として利用し、 Datadog APM の Span 情報と組み合わせて Canary のみを対象としたカスタムメトリクス を発行します。
これにより、Canary にデプロイされたアプリケーションについて、
- 成功数・エラー数・エラーレート
- すべてのエンドポイントごとの挙動
を Stable と分離して正確に観測できるようになりました。
Datadog Span Metrics による Canary メトリクス
Datadog の Span Metrics を使うことで、APM トレースを元に任意の条件でメトリクスを定義できます。
今回は以下の条件を使って Canary を特定しています。
- argo_rollouts_revision:canary
- status:ok / status:error
これにより、Canary の挙動のみを切り出したメトリクスを扱えるようになります。
Canary 成功リクエスト数
# サンプル
resource "datadog_spans_metric" "canary_ok" {
  name = "canary.request.ok"

  compute {
    aggregation_type = "count"
  }

  filter {
    query = <<-EOT
      env:${var.env}
      service:${var.service}
      operation_name:${value.operation}
      @span.kind:${value.span_kind}
      argo_rollouts_revision:canary
      status:ok
    EOT
  }

  group_by {
    path = "resource_name"
  }
}
Canary エラーリクエスト数
# サンプル
resource "datadog_spans_metric" "canary_error" {
  name = "canary.request.error"

  compute {
    aggregation_type = "count"
  }

  filter {
    query = <<-EOT
      env:${var.env}
      service:${var.service}
      operation_name:${value.operation}
      @span.kind:${value.span_kind}
      argo_rollouts_revision:canary
      status:error
    EOT
  }

  group_by {
    path = "resource_name"
  }
}
カスタムメトリクスのコスト対策
カスタムメトリクスはとても便利ですが、フィルタ条件のミスなどによってコストが膨らむリスクがあります。 そのため、カスタムメトリクス自体の使用量を監視する Monitor をあらかじめ用意しておきました(実際にこれにより助かりました・・)。
# サンプル
resource "datadog_monitor" "custom_metric_cost_guard" {
  name = "Datadog カスタムメトリクスの使用量監視"
  type = "query alert"

  new_group_delay     = 60
  on_missing_data     = "default"
  require_full_window = false

  monitor_thresholds {
    warning  = 2500
    critical = 3000
  }

  query = <<-EOT
    avg(last_5m):
      sum:datadog.estimated_usage.metrics.custom.by_metric{*}
      by {metric_name}
    > 3000
  EOT

  message = <<-EOT
    カスタムメトリクスの使用量が想定を超えています。
    フィルタ条件や不要な定義を確認してください。
  EOT
}
Canary 用 Datadog Monitor
リクエスト数モニター
一定以上のトラフィックが流れている Canary のみを対象に、リクエスト数を監視します。
# サンプル
resource "datadog_monitor" "canary_request_count" {
  name = "[Canary] すべてのエンドポイントのリクエスト数"
  type = "query alert"

  new_group_delay     = 0
  on_missing_data     = "resolve"
  require_full_window = false

  monitor_thresholds {
    critical = var.request_count_threshold
  }

  query = <<-EOT
    sum(last_5m):
      default_zero(sum:canary.request.ok{*} by {resource_name}.as_count())
      +
      default_zero(sum:canary.request.error{*} by {resource_name}.as_count())
    >= ${var.request_count_threshold}
  EOT
}
エラーレートモニター
# サンプル
resource "datadog_monitor" "canary_error_rate" {
  name = "[Canary] すべてのエンドポイントのエラーレート"
  type = "query alert"

  new_group_delay     = 0
  on_missing_data     = "resolve"
  require_full_window = false

  monitor_thresholds {
    critical = var.error_rate_threshold
  }

  query = <<-EOT
    sum(last_5m):100 *
      default_zero(sum:canary.request.error{*} by {resource_name}.as_count())
      /
      (
        default_zero(sum:canary.request.ok{*} by {resource_name}.as_count())
        +
        default_zero(sum:canary.request.error{*} by {resource_name}.as_count())
      )
    > ${var.error_rate_threshold}
  EOT
}
余談:on_missing_data = "resolve"
Terraform では設定できますが、Datadog UI からは該当する設定項目を見つけられませんでした 🤔
もしご存知の方がいれば、ぜひ教えてください 🙇♂️
複合条件モニターと AnalysisTemplate
上記の Monitor を組み合わせ、一定以上のトラフィックがある状態でエラーレートが悪化した場合のみ Alertとなる複合条件モニターを作成しています。
# サンプル
resource "datadog_monitor" "canary_composite" {
  name = "[AnalysisTemplate] Canary エラーレート(一定トラフィック以上)"
  type = "composite"

  query = <<-EOT
    "${datadog_monitor.canary_error_rate.id} && ${datadog_monitor.canary_request_count.id}"
  EOT

  message = <<-EOT
    このモニターは Argo Rollouts の AnalysisTemplate に組み込まれています。
    Alert 時は Canary リリースが自動でブロックされます。
  EOT
}
その他:Canary の可視化と通知について
Canary の状態は、Datadog ダッシュボード上で Canary 専用メトリクスのみを表示することで可視化しています。
また Slack 通知については、AnalysisTemplate に影響する Alert のみに絞ることで、ノイズを抑えつつ重要な変化を見逃さない運用を意識しています。
まとめ
Datadog の標準メトリクスだけでは、Canary の異常が見えづらい場面に遭遇しました。 そこでカスタムメトリクスを活用することで、Canary の状態を正確に観測できるようになりました。
これらのメトリクスをモニター(複合条件モニター)で使用し、AnalysisTemplate に組み込むことで、 自動かつ安全な Progressive Delivery 基盤を実現できるようになりました。
本記事が、同じような課題を持つ方の少しでも参考になれば嬉しいです。
おわり
Datadog ともっと仲良くなりたいので他の方の記事も読ませていただこうと思います!
いま1番気になっているのはこちらの記事です 👀
